AI 辅助工程的两个极端:一路狂飙,还是慢工细作
所属系列
- AI 辅助工程系列 (18 共 18)
我和编程 agent 有两种很不一样的相处方式。
一种是,我描述自己想要什么,agent 把它做出来(有时十几个一起上 🙈),然后我运行一下,看喜不喜欢。我几乎不读代码。“能用就行 ™️。”过去 12 个月,我做了 10,000 多次提交,很大一部分就是这么来的。🚀
另一种就很不一样了。光是一个函数叫什么名字,我们都可能花上出乎意料的时间。
工具一样。往往连 agent 都一样。规矩却完全不同。
有一阵子,我把它们看作两类项目。现在,我更愿意把它们看作一条连续谱的两端,而项目可以沿着它移动。我的 Elite Dangerous 座舱助手 EDControlRoom 就是从快的那一端起步的,不到两周便有了能用的版本。后来,为了打好让它继续成长的基础,我不止一次放慢了速度。
所以,这篇文章不打算评判哪一端才对。我想聊的是,怎么决定一个项目此刻该处在什么位置,以及如何一遍遍地追问:这个判断现在还成立吗?
一条连续谱,不是一份判决
“极端”不是褒贬。不是一端叫偷懒,另一端才叫正经做事。它们是在用两种方式回答同样的问题:我现在想让多少东西跑起来?多少工作交出去,多少留给自己?
大致可以这样看:
| 能用就行 ™️ | 质量要紧 | |
|---|---|---|
| 谁做决定 | agent;我判断结果 | 我;agent 提供信息、建议并核实事实 |
| 我看什么 | 能不能运行,看起来对不对 | 代码、测试,以及每一个重要的决定 |
| 节奏 | agent 能多快就多快 | 我能跟上多快就多快,一步一步来 |
| 测试 | agent 自己加;全绿让我安心 | 每个测试都验证一项我能说清楚的行为保证 |
| 我得到什么 | 很快得到一个接近想象的东西。但还不能完全一样 | 我能读懂、修改和解释的代码 |
| 代价是什么 | 藏起来的烂摊子,以后再还 | 现在就投入我的时间和注意力 |
| 适合什么 | 原型、个人工具、游戏,以及我想看看做出来会怎样的点子 | 要长期存在、会被别人阅读或依赖的代码 |
我的大部分工作都在中间某个位置。我可以让 agent 放手处理常规部分,然后在某个棘手的边界上慢下来。一个项目该放在哪里,取决于我的质量标准,以及我愿意为这个项目承担多少风险。
要给项目找准位置,我会问三个问题:
- 这段代码需要用多久? 一个周末实验,和一个我会依赖好几年的工具,值得投入的心思不一样。
- 还有谁会读它? 如果只有我自己,我能接受“反正 agent 把它弄能用了”。如果别人会在它的基础上继续开发,或问我为什么这么设计,那就不行。
- 一个藏着没发现的错误会造成多大代价? 如果是我做着玩的游戏,我发现问题,agent 修好。如果我需要做出可靠的东西,我就希望错误尽可能少,并且尽我所能地把一切检查透彻。如今,这些检查也有 agent 帮忙。
答案不是固定的。一个开始有人使用的原型,需要的答案就和第一天不一样。所以,项目可以在两栏之间移动,而且应该移动。放在哪里是一个需要主动做出的决定,而不是忙着开发时自然而然落下的位置。
快的那一端:能用就行 ™️
我的项目页上,大部分东西都是这样做出来的。tmux-agents,我每天用来运行这些 agent 的工具。Cosmic Civilization Builder,一个浏览器放置游戏。Project Stone Age,用 Godot 重制 MMORPG 石器(Stone)时代(Age)。还有 EDControlRoom。至少,它起初是这样的。
它们的循环都一样。描述我想要的效果。让 agent 去做。运行。看着对吗?发布。🚀 如果看着不对,就描述哪里不对,再来一轮。
我不看 diff 了……已经不看了……🙈 这些代码库是怎么长起来的,我一直在场,所以大体结构我知道。但如果你问我,某个模块为什么是现在这个样子,很多时候,诚实的回答只能是:🤷♂️ “agent 把它弄能用了,就这样。”
这看起来可能有些草率。其实不是。这是我一开始就有意做出的选择。 这些是我自己用的工具,和做着玩的游戏。没有别人依赖它们。没人会要求我解释它们为什么这么写。也没有什么生产环境会被我搞挂。哪里出了错,我发现,agent 修好。
而且,真的太好玩了。脑子里的想法,一个晚上就能出现在屏幕上,有时只要一个小时。没有这种模式,那些项目大多还只会是想法。
代价会在哪里冒出来
不过,代价确实会找上门。
测试慢到快跑不动了!
现在 agent 已经足够能干,这些项目都有了测试套件。大部分测试都不是我要求的;agent 会加测试,因为这看起来才像好的工程实践,而我也就随它们去了。但测试全绿到底说明了什么,我其实不太清楚。写代码的 agent 又来写测试,很容易只是在照着代码写一遍,而不是检验我关心的行为。没人认真审视过这些测试,也就没理由对它们抱太高期待。
而且,它们是有成本的。Project Stone Age 的测试套件,和那个仓库里的其他东西一样,一次加一个功能,每个功能配上测试,却没人审查这些测试要花多少时间。最夸张的时候,八个线程跑完整套测试也要接近一个小时。每个功能都开始显得很慢,哪怕是很小的功能,因为慢的是测试。于是我定了一条规矩:不要每次都跑全套,只在合回 main 时跑。这种规矩,哪怕只是沾上生产环境的边,我都不会接受。但个人项目嘛?“没事的。🔥” 后来还做过一轮提速,方式也一样:描述问题,让 agent 修,再看看有没有变快。快了。一点点。🥲
还有那些没说清的地方。小心,它们会滚成雪球!
当我只从大方向描述结果时,所有没交代的细节,agent 都会替我补上。这就是为什么结果总是接近我的想象,却又总差那么一点。每一处空白都很小。但它们会叠加,放着不管,雪球就会一直滚,直到以每小时 100 英里的速度撞上你。🦆!
“疯狂惊人快到离谱模式”™️
这些都没让我想放弃快的那一端。慢测试和几个雪球,就是这种模式的代价;对这些项目来说,这个代价值得。关键是,要察觉到项目什么时候已经长大到不再适合它。
沿着连续谱移动:EDControlRoom
EDControlRoom 是 Elite Dangerous 的座舱助手。它读取游戏日志,根据飞船上正在发生的事情作出反应,并执行在空间站之间运货之类的例程。它也是我手头最清楚的一个例子,说明项目如何沿着这条连续谱移动,而且不止一次。
先一路狂飙 🚀
第一次提交是在 2026 年 5 月 25 日。不到两周,它已经能在游戏里干实事了,随后在 6 月 7 日发布了 v1.0.0:一个显示实时飞船状态、调度例程的终端 Control Room。接着,四天里发了十一个版本,到第二周就支持 Windows 了。
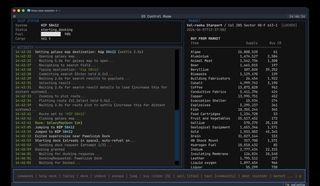
v1.0.0 发布当天的终端 Control Room。
至于内部实现,它完全属于快的那一端。从工程角度看,还很粗糙。但它能用,而且能稳妥地处理游戏事件,这才是真正要紧的部分。发布时甚至已经有了 154 个测试。我读过吗?😅
慢下来,打好基础
到了第三周,我想要一个现有代码给不了的东西。我想让 Control Room 跑在游戏 PC 上,和游戏放在一起,再从 Mac 的终端控制它。这不是随手加上去的功能。于是我慢了下来。我们先把客户端和服务器之间的协议写成文档,再动手实现:服务器在游戏旁边运行,客户端通过 REST 和 WebSocket 与它通信。v1.12.0,“Client-Server Split”,在 6 月 19 日发布。
十天后,我又慢了下来。每个客户端仍然用自己的一套方式,把服务器数据变成界面。我们先规划重构,再花了一天,也就是 52 次提交,来实现它:给每个面板建立视图模型,服务器只提供一条数据流,所有客户端都基于它渲染。这就是后来的 v1.17.0,“Composable Control Room”。
正是在这些时候,我不再只是描述效果,而开始亲自做决定。服务器负责什么?客户端可以做什么?数据是什么结构?不是每一行代码,而是整体结构。
基础开始发挥作用
有了这些,做一个 Web 界面的成本就很低了。几天内,第一个运货网页就出来了,到了 7 月中旬,又有了路线规划。
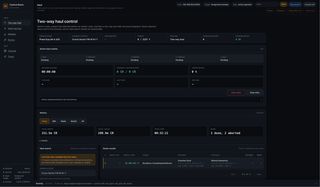
如今的 Web Control Room,正在执行双向运货。
然后我去度假,又忙起了其他事情,将近四个月没再碰它。11 月回来时,重新上手很轻松。不到一周,它就加上了 Linux 和 Steam Deck 支持、更好的语音、用于操作例程的 Web 按钮面板,以及根据实时市场数据生成的贸易路线。
接着是 hub 模式:家里网络上的一个 Control Room 会发现其他 Control Room,负责路线搜索和市场数据库,并且可以监控和控制其中任意一个。它完全建立在 6 月做好的 REST、WebSocket API 和那条数据流之上。一天就完成了:11 月 11 日,114 次提交,六个版本。🤯
再慢一点
如今它到了 v1.38.0,大约 880 次提交,测试套件从 154 个测试增长到了 1,171 个。接下来,我想把它当作学习 Rust 的试验场,把那些已经足够稳定、不太会再变动的部分迁到 Rust。
如果一开始就用 Rust,小心翼翼,每个决定都由我来做,我不会走到这里。我大概还在琢磨协议。这个项目让我有那么多想法,而它之所以一直在前进,正是因为我先选了一路狂飙。现在,有些部分不再频繁变动了,也就值得慢下来仔细打磨。
这就是这个过程。先快跑,弄清楚它应该是什么。形状清楚了,就慢下来打基础。然后在基础上再次快跑。对于已经定下来的部分,再放慢一些。
质量对我意味着什么
那么,慢下来以后,变化是什么?首先,“好代码”不再是一句足够明确的要求。让 agent“写高质量代码”,几乎等于把所有事情都留给它决定。我需要一套标准,能用来判断下一个函数、下一个测试,以及下一个提议中的抽象。
对我来说,这意味着:
- 可读。 名字表达意图,函数职责集中,注释解释为什么。
- 组织清楚。 每个部分都有明确的职责,需要修改时,一眼就知道该改哪里。
- 依赖明确。 能看出一个组件需要什么,也能在测试或预览中轻松替换它。
- 把规则放进类型。 在边界处拦住无效数据,让其余代码少作一些假设。
- 业务逻辑准确。 重要规则明确、独立,并且可以单独测试。
- 测试有意义。 检验可观察的行为,抓住可能出现的错误,而不是复刻实现或追逐覆盖率。
这些都不新鲜。它们是熟悉的工程原则。新的地方在于,现在代码堆起来太容易了,速度远远超过我判断它们的速度。有了 agent,这些原则不会自动落实。我必须专门为它们留出空间。
有两个问题,能帮我把这些原则用到实际代码上:
- 如果旁边没有 agent 解释这是什么意思,另一个人能读懂吗?
- 如果需求变了,我能看出该在哪里修改吗?
它们让我和 agent 有了具体的讨论依据,也避免“质量”悄悄变成“看着像我熟悉的代码就行”。
谁做决定,谁定节奏
在快的那一端,agent 做大部分决定,我判断结果。在仔细的那一端,分工正好反过来,而且我会一开始就说清楚:我做决定,agent 提供信息。
我:
- 我做决定。 命名、结构、API 的设计、产品取舍。
- 我写代码,或者读代码。 无论哪种,没弄明白就不合入。
- 我定节奏。 某个细节确实重要,就在上面待到做对为止,再往下走。
agent:
- 把地图铺开。 找出我还没看到的事实和约束。
- 提出建议。 我征求建议时,它给出选项和背后的理由,然后我们继续推敲。
- 做基础工作。 测试、脚手架,以及我交代的部分,但先和我过一遍计划。
- 审阅。 指出哪里好、缺什么,以及哪里还可以更好。
把决定摆到明面上
agent 能把一句简短的要求变成大量代码。在这个过程中,它会选名字、划边界、解释我没说清的需求,并决定出错时怎么办。我的要求里每一处空白,都有一个待做的决定;在快的那一端,agent 就默默替我做了。
在仔细的那一端,我希望这些决定还容易修改时,就拿到对话里来讨论。这个组件负责什么?这个类型带着哪些假设?这种行为是确实需要,还是只为了实现方便?
agent 的想法经常更好,我也常常采纳它的建议。要紧的是,我得足够理解这个选择,才能真正为它负责。
各位人类,节奏要自己定
agent 能一次处理很多东西。问一句“从哪里开始?”,它可能就把整个项目的六个方面一起端上来:架构、目录结构、测试策略、数据模型、边界情况,以及接下来的三个功能。都挺有道理。agent 能一口气处理完。我不能,至少在我想真正亲自做这些决定时不能。
所以,这种时候,定节奏是我的工作,而且不能省。挑一件事。做出决定。再到下一件。只要我允许,agent 很乐意一路加速。到底多快,仍然由我决定。
核实事实
agent 可以听起来无比笃定,却仍然是错的。再自信地解释一个库或 API 的行为,也仍然只是一种说法。重要的地方,我们会拿文档、小实验或真实系统来核实。agent 也很擅长执行这些检查。但解释的作用是帮我理解证据,不能代替证据。
一次只走一小步
所以,“一次只做一件事”进入了我的常用语,后来又成了 agent 指令里的一个 tiny slice 技能。
好的一小步,要对应一个真实的行为。有人输入一个值、改变一个选项、重试一次操作,或看到一个结果。我们先说好应该发生什么,找出实现它需要的状态,然后就把这一点做出来。我们常常从一个测试开始。有时也会先摸清代码,因为结构还不明确。无论哪种,这一步都要足够小,让我能跟上输入、理解决定、检查结果,而不必把一整个尚未完成的系统装在脑子里。
“小”也需要拿捏。把答案写死,当然能让测试通过,却绕过了我们本来要实现的行为。好的一小步,要保留完整的真实流程,只限制一次承担多少内容。
小步前进,也给设计留下了生长的时间。在弄明白一个抽象应该负责什么之前,我可以先不引入它。每一步都会为下一个决定提供依据。途中冒出来的其他事情,记下来,放到以后再处理。
连这篇文章也是这么写的。前两稿都是整篇一次写出来的,两篇都不像我。所以这一版,我们先定大纲,再一节一节写;每写完一节,我都读过、改过,才继续下一节。
测试全绿能告诉你什么
在快的那一端,测试全绿让我安心,我大多也就到此为止。EDControlRoom 有 1,171 个测试,但它们大部分到底保证了什么,我说不上来。在仔细的那一端,测试套件也是代码库的一部分,我需要理解它。
对于每个重要的测试,我都想知道,它检验了什么保证,哪种可能出现的错误会让它失败。预期结果必须从“行为应该是什么”出发,独立推导出来。如果 agent 写完代码,再把代码返回的东西抄进测试当作预期值,那这个测试证明的,只是代码确实做了代码所做的事。
这改变了我要求测试的方式。我不会只说“给这个函数写测试”,而是描述重要的行为,再问:如果它出错,我们怎么发现?边界情况值得加入测试,是因为它能区分正确行为和那种看起来没问题、其实不对的实现。
测试替身也值得同样的关注。一个 fake,如果遇到没有预先设置的调用就悄悄返回空结果,可能会掩盖一个我不知道的依赖。如果它改为明确报错,比如来一句 fatalError("yell at me pls"),测试就会告诉我,它实际执行的范围比我预想的更大。
好的测试检验行为,而不是实现细节。它们从外部描述代码在做什么:给定这个输入,用户看到那个结果。它们不会断言内部调用了哪个函数、顺序如何、传了什么参数。那种测试,每次我重新组织代码都会坏,哪怕用户能察觉到的行为一点没变。检验行为的测试让我可以自由调整结构,只有真正重要的东西出了问题时才失败。我把这些写成了一个 behavior tests 技能,让 agent 也从这里出发:测试沿着用户的操作流程来写,依赖则以普通函数的形式传入。
而且,测试是有成本的。Project Stone Age 教会了我这一点。如果一个套件让每个小改动都变慢,就会影响我运行它的频率,也会影响我多快能发现问题。测试同样需要工程判断。
所以,EDControlRoom 对测试有耗时标准。从第二周起,测试套件就有了时间预算。如今的预算是每个测试 0.6 毫秒,因此它会随测试数量增长:全部 1,171 个测试,大约 0.7 秒。如果一次运行超了预算,agent 就找出最慢的测试并修好,通常是移除真实的等待,或改成传入一个时钟。CI 也会兜底,如果整套测试超过五秒,构建就失败。agent 每次改完都会跑全套测试,所以测试快,整个循环就快。(写到这里时,它跑完大约要 0.8 秒,略微超出预算。得接着干活了。)
名字和边界
有些最有用的讨论,聊的都是小事。
一个名字告诉下一个读代码的人,这个值是干什么的。一个类型告诉他们,哪些假设可以放心使用。一个依赖告诉他们,一个组件需要从外界获得什么。每一项都带着一点上下文,否则这些上下文就只会留在我脑子里,或某个 agent 的聊天记录中。
所以,如果一个名字藏住了用途,我就会问。如果每个调用方都得记住同一条校验规则,我们就找一个边界,在那里统一保证这条规则。如果一个组件悄悄去取全局状态,我们就会讨论:把它需要的东西传进来,会不会让它的职责更清楚?
这些选择,让人在代码里安全地做事时,不用同时记住那么多东西。它们也让下一次 agent 会话少一些猜测的空间。
不过,也有限度。小应用不需要因为大应用可能用得上,就堆出一层层协议和仓储抽象。每个抽象都应该有一个我能解释清楚的职责。
写下来
仔细做事,很容易越聊越开,最后每一步都变成对所有可能的边界情况的讨论。我需要一种方式,能说“这很重要,我们会回来处理”,又不用放下手头的事,也不用指望自己一定记得。
所以,agent 会记笔记。做了什么决定,为什么这样决定。对于所依赖的系统,我们弄明白了什么。还有没解答的问题、暂时放下的边界情况,以及下一步。有了这些笔记,我晚上就可以收工,不必把整个项目装在脑子里;新的 agent 会话也能接上进度,不用靠猜重新拼出设计。
有意推迟处理,和彻底忘掉一个问题,是有区别的。两者都还没解决。但只有前者,在待办清单里有自己的位置。
我们如何协作,也是一样。如果同一个问题我纠正了两次,它就会进入 agent 的指令。写代码之前先讨论计划。一次只走一个能跟上的小步。陌生的概念,等用到时再解释,不要一上来先讲一堂课。决定做完就记下来。那个文件里的每条规则,都来自一次真实的纠正。连写这些规则,也有专门的技能 agent-docs,让指令足够简短、清楚,agent 才真的能遵循。
而在清空会话之前,我会请 agent wrap up:我们学到了什么还没写下来?还有什么没做完?这样,清空会话就不等于丢掉这次会话带来的经验。
规则让我们的协作方式可以重复。但 agent 偏离规则时,我仍然得自己察觉。
代价是什么
在仔细的那一端,我一直很忙。
我读、问、选择,有时还亲自写代码。另一些时候,agent 写,我们再一起过一遍。两者的比例,取决于任务,也取决于我想理解到什么程度。
这很慢。一个不大的功能,也会变成好几轮对话。agent 可能说得笃定却说错了,也可能接受了纠正,过一会儿又犯同样的错。
而且,仔细不等于毫无缺陷。审阅会漏东西。测试有空缺。还有一些假设等着核实。我得到的是一幅更清楚的图景:我知道什么、验证过什么、薄弱处在哪里。这些是在开发时记下来的,不是等有人问起才发现。
agent 能带来很多东西:调研、解释、提案、实现、审阅和记忆。当我还有足够注意力去判断它给出的东西时,我才能从中受益最多。这份注意力,才是仔细那一端真正的成本,也正因为如此,我不会把它花在每个地方。
有意识地定下标准
所以,有两个极端,中间还有很大的空间。
快的那一端,让我有了一大批每天使用、每天享受的项目,也贡献了过去一年 10,000 多次提交中的很大一部分。仔细的那一端,则给了我愿意让任何人读的代码、真正信任的测试,以及随时能解释清楚的决定。
两者都不是与 agent 协作的唯一正确方式。真正要决定的,不是用什么工具,甚至也不是选哪一端,而是此时此刻,这个项目的质量标准该定在哪里。代码需要用多久?还有谁会读?一个藏着没发现的错误会造成多大代价?根据这些答案,有意识地定下标准,再让与 agent 的协作方式跟着调整。
然后继续问。 EDControlRoom 起步时一路狂飙,因为我需要弄清它该是什么样。需要基础时,它慢了下来;在基础上,它又加快了速度;而那些已经定下来的部分,很快就要用 Rust 进一步慢下来、仔细打磨。每一次调整,都没有错。
答案会变。变了,就跟着移动。