幕后:和 GPT 结对撰写 Umami 文章
所属系列
- AI 辅助工程系列 (4 共 15)
Umami + Ansible 那篇文章,我在脑子里酝酿了很久,但它涉及三个不同的仓库和一大堆代码片段。做得来,却也确实繁琐,所以一直被往待办列表后面推。完成后的文章在这里:用 Umami、Docker Compose 和 Ansible 搭建私有分析服务。
最终推动它落地的想法很简单:何不让 GPT(Codex)负责繁重工作,由我把握方向?
做好准备
- 我列出了故事的主要脉络,并坚持所有代码引用都使用我的 Eleventy
{% github %}短代码,让读者能看到实际代码片段。 - 由于文章涉及多个仓库,我让 GPT 先用
ghCLI 确认每个仓库的 URL,并取得最新的main提交 SHA,再嵌入内容。 - 我明确了要求:收集片段行号范围,把它们和正确的提交哈希一起放进短代码,并补上我可能遗漏的内容。
- 我们一起复核了流程。以下是约定计划的简版:
- 阅读几篇已有文章,沿用其语气和结构。
- 查看 Umami role 和 Lighthouse playbook,收集关键片段。
- 用
gh repo view/gh api取得涉及的各个仓库最新的mainSHA。 - 起草文章,穿插固定到这些提交的
{% github %}嵌入内容。 - 校对准确性、链接和文风。
看得出来,这项任务相当复杂。我没有期待完美,只希望结果够用。
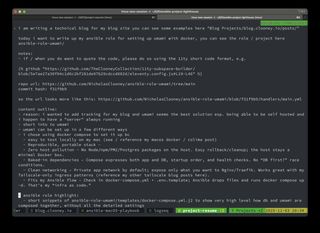
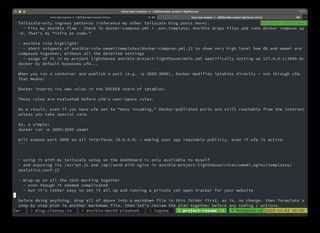
但 GPT 做到了!而且远超预期!
下面是 GPT 在动任何文件之前,先把工作梳理成多步计划:
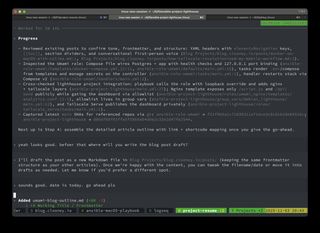
看着工作流展开
计划确定后,GPT 的执行非常顺畅。它取到了正确的文件,记录行号,插入了我需要的确切短代码。草稿出来时,没有失效链接,也没有不匹配的哈希,那感觉有点不真实:所有嵌入内容第一次就正确渲染了。
唯一的小问题?GPT 没发现我的 config/main.yml 在 Git 中是以 .template 文件保存的。这种错误太像人会犯的了,我发现时忍不住笑了。把短代码里的 main.yml 改成 main.yml.template,一切就对上了。
真正让我印象深刻的,是它对较复杂指令的处理:
- 它逐个深入仓库,提取我关心的片段:
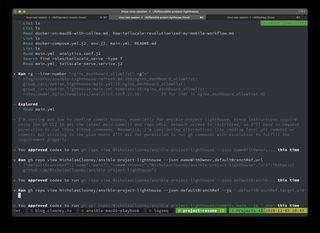
- 需要时执行 shell 命令,检查文件并获取提交 SHA:
- 运行
gh命令确认仓库和默认分支。 - 在引用任何代码之前取得
main上最新的提交 SHA。
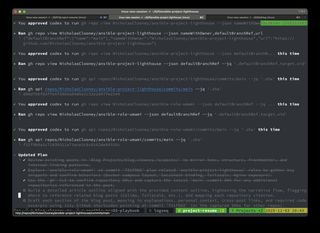
- 它整理出的提纲,也正是我一直拖着没写的内容:
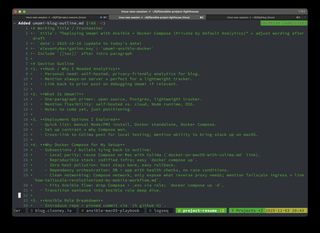
- 每段嵌入都使用
{% github "https://github.com/.../blob/<sha>/path#Lxx-Lyy" %}格式,并带上精确的行号范围。
原本以为需要手把手带着走的工作流,GPT 基本上直接交出了一份成熟的草稿。
这为什么有意义
这不只是“让 AI 来写”。这是一次真正的结对写作:GPT 遵循复杂要求,协调多个仓库,产出了一篇我愿意自豪地发布的文章。我仍然提供方向并审阅成果,但繁琐劳动消失了。
如果你也因为整理代码片段太费事,而迟迟没写某篇文档型文章,可以试试这个方法。把指令说清楚,让 GPT 处理杂活,最后的编辑审阅留给自己。我非常惊喜,也有点期待很快再交给它一篇棘手的文章。